Визуализация
Данные: Случайные
Легенда цветов
Как работает внешняя сортировка слиянием
Идея алгоритма. Когда данных больше, чем помещается в оперативной памяти (например, нужно отсортировать файл на 100 ГБ при памяти 4 ГБ), обычные алгоритмы не справятся. Решение - разделить данные на куски, которые влезают в память, отсортировать их и слить вместе.
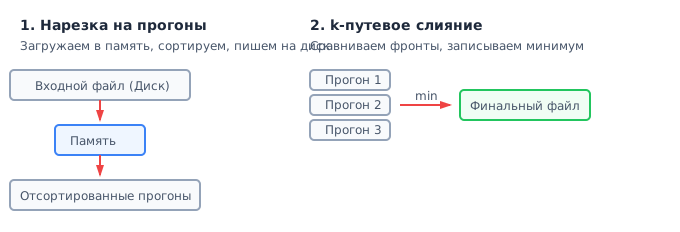
Фаза 1: Нарезка на прогоны (Runs). Читаем с диска столько элементов, сколько вмещает наша память (M элементов). Сортируем этот кусок прямо в памяти любой быстрой сортировкой (обычно QuickSort) и записываем обратно на диск во временный файл - "прогон" (run). Повторяем, пока не прочитаем весь входной файл.
Фаза 2: Слияние (Merge). Теперь у нас есть несколько отсортированных временных файлов. Открываем их все на чтение, берем по одному первому элементу (фронту) из каждого. Выбираем наименьший из них и записываем в итоговый файл. Загружаем следующий элемент из того прогона, чей элемент мы только что записали. Так мы получаем полностью отсортированный результат, держа в памяти всего по одному элементу от каждого прогона.
Синонимы названия. Этот алгоритм также известен как внешняя сортировка слиянием, многопутевое слияние (k-way merge) и external merge sort.
Сложность алгоритма
Сложность - это оценка того, как быстро растет потребление ресурса при росте длины массива n. Ресурса у алгоритма два, поэтому и оценки две: по времени и по памяти. Обе записывают через O-нотацию - у нас есть отдельная анимация о том, как читать такие записи.
По времени
Показывает, как растет число операций (здесь это сравнения и обмены) при росте n. Лейбл "Сложность" под визуализацией - время, которое получилось фактически на ваших данных.
| Характеристика | Оценка | Комментарий |
|---|---|---|
| Число сравнений | O(n log n) | Такое же, как у обычной сортировки слиянием в памяти |
| Число обращений к диску (I/O) | O(n log(n/M)) | Каждый элемент считывается и записывается при создании прогонов и на каждом уровне слияния |
По памяти
Показывает, сколько дополнительной памяти нужно алгоритму. Сам входной массив в эту оценку не входит: дополнительной считается память сверх него.
| Характеристика | Оценка | Комментарий |
|---|---|---|
| Дополнительная память (RAM) | O(M) | M - размер доступной памяти. Мы читаем данные блоками по M элементов |
| Дополнительная память (Диск) | O(n) | Требуется место на жестком диске для хранения временных файлов-прогонов |
Устойчивость алгоритма
Устойчивой называется сортировка, которая не меняет взаимный порядок равных элементов. Пример: сортируем учеников по оценке, а внутри одной оценки они уже стояли по алфавиту. Устойчивая сортировка сохранит алфавитный порядок внутри каждой оценки, неустойчивая - может перемешать.
| Характеристика | Оценка | Комментарий |
|---|---|---|
| Устойчивость | Да | Внешняя сортировка сохраняет стабильность, если при слиянии равных элементов предпочтение отдается элементу из прогона, который был записан раньше. |
Примеры реализации внешней сортировки
Код на C
#include <stdio.h>
#include <stdlib.h>
// CHUNK_SIZE определяет, сколько элементов (чисел) поместится в оперативной памяти за один раз.
// Это и есть то самое ограничение памяти M, о котором говорится в теории.
#define CHUNK_SIZE 10000
// Стандартная функция сравнения, нужная для библиотечной функции qsort
int compare(const void* a, const void* b) {
return (*(int*)a - *(int*)b);
}
void external_sort(const char* input_file, const char* output_file) {
FILE* in = fopen(input_file, "r");
if (!in) return;
// Выделяем память под буфер. Больше, чем CHUNK_SIZE элементов, мы сюда не загрузим
int* buffer = (int*)malloc(CHUNK_SIZE * sizeof(int));
int num_runs = 0;
int count = 0;
// =========================================================
// ФАЗА 1: Чтение частями, сортировка в ОЗУ и запись прогонов
// =========================================================
while (fscanf(in, "%d", &buffer[count]) == 1) {
count++;
// Если буфер заполнился - сортируем и сбрасываем во временный файл
if (count == CHUNK_SIZE) {
// Быстрая сортировка "на месте" внутри оперативной памяти
qsort(buffer, count, sizeof(int), compare);
char run_name[256];
sprintf(run_name, "run_%d.tmp", num_runs++);
// Записываем отсортированный прогон (run) на диск
FILE* out = fopen(run_name, "w");
for (int i = 0; i < count; i++) fprintf(out, "%d\n", buffer[i]);
fclose(out);
count = 0; // Сбрасываем счетчик для следующего чанка
}
}
// Если после чтения всего файла в буфере остались данные, их тоже нужно отсортировать и сбросить
if (count > 0) {
qsort(buffer, count, sizeof(int), compare);
char run_name[256];
sprintf(run_name, "run_%d.tmp", num_runs++);
FILE* out = fopen(run_name, "w");
for (int i = 0; i < count; i++) fprintf(out, "%d\n", buffer[i]);
fclose(out);
}
fclose(in);
free(buffer);
// =========================================================
// ФАЗА 2: k-путевое слияние отсортированных прогонов
// =========================================================
// Массив указателей на все наши открытые временные файлы
FILE** runs = (FILE**)malloc(num_runs * sizeof(FILE*));
// Массив для хранения "головных" (первых) элементов каждого прогона
int* current_vals = (int*)malloc(num_runs * sizeof(int));
// Массив флагов, показывающий, не закончился ли файл (1 - есть данные, 0 - конец файла)
int* active = (int*)malloc(num_runs * sizeof(int));
// Открываем все файлы-прогоны и считываем по одному (первому) элементу
for (int i = 0; i < num_runs; i++) {
char run_name[256];
sprintf(run_name, "run_%d.tmp", i);
runs[i] = fopen(run_name, "r");
active[i] = (fscanf(runs[i], "%d", ¤t_vals[i]) == 1);
}
FILE* out = fopen(output_file, "w");
while (1) {
int min_idx = -1;
// Линейный поиск минимального элемента среди всех "голов" прогонов.
// При большом количестве прогонов здесь эффективнее использовать кучу (Min-Heap)!
for (int i = 0; i < num_runs; i++) {
if (active[i]) {
if (min_idx == -1 || current_vals[i] < current_vals[min_idx]) {
min_idx = i;
}
}
}
// Если ни одного активного файла не осталось - мы все слили
if (min_idx == -1) break;
// Записываем найденный минимум в результирующий файл
fprintf(out, "%d\n", current_vals[min_idx]);
// И сразу читаем следующий элемент из того прогона, откуда только что забрали минимум
active[min_idx] = (fscanf(runs[min_idx], "%d", ¤t_vals[min_idx]) == 1);
}
fclose(out);
// =========================================================
// Очистка: закрываем и удаляем за собой все временные файлы
// =========================================================
for (int i = 0; i < num_runs; i++) {
fclose(runs[i]);
char run_name[256];
sprintf(run_name, "run_%d.tmp", i);
remove(run_name);
}
free(runs); free(current_vals); free(active);
}Код на Python
import tempfile
import heapq

def external_sort(input_file, output_file, chunk_lines=10000):
    temp_files = []

    # =========================================================
    # ФАЗА 1: Чтение частями, сортировка в памяти и запись прогонов
    # =========================================================
    with open(input_file, 'r') as f:
        while True:
            # Читаем кусок файла построчно (chunk). Гарантируем, что
            # размер куска не превысит наш лимит памяти chunk_lines.
            chunk = []
            for _ in range(chunk_lines):
                line = f.readline()
                if not line: break
                chunk.append(line)

            if not chunk:
                break # Достигли конца файла

            # Сортируем прочитанный кусок данных в памяти.
            # В Python метод .sort() использует алгоритм Timsort - это очень быстро.
            chunk.sort()

            # Создаем временный файл (прогон) и записываем туда отсортированный кусок.
            # Временные файлы автоматически удаляются при закрытии, но нам нужно их еще читать,
            # поэтому ставим delete=False.
            temp = tempfile.NamedTemporaryFile(mode='w+', delete=False)
            temp.writelines(chunk)

            # Обязательно перематываем файловый указатель в начало файла,
            # чтобы при слиянии начать чтение с первого элемента прогона.
            temp.seek(0)
            temp_files.append(temp)

    # =========================================================
    # ФАЗА 2: Многопутевое (k-way) слияние отсортированных прогонов
    # =========================================================
    with open(output_file, 'w') as f_out:
        # heapq.merge - это идеальное решение для k-путевого слияния!
        # Под капотом он организует итераторы файлов в Min-Heap (кучу минимумов).
        # В памяти одновременно находится только по одной строке из каждого файла-прогона.
        for line in heapq.merge(*temp_files):
            f_out.write(line)

    # После завершения слияния аккуратно закрываем временные файлы,
    # что позволит ОС окончательно удалить их с диска.
    for temp in temp_files:
        temp.close()
Код на JavaScript (Node.js)
// ПОЧЕМУ NODE.JS, А НЕ БРАУЗЕРНЫЙ JS:
// 1. Доступ к файловой системе: модуль fs позволяет создавать, считывать и удалять
//    временные файлы-прогоны (run_0.tmp) прямо на диске или SSD. В браузере такого доступа нет.
// 2. Потоковое чтение (Streams & Readline): с помощью readline и асинхронных итераторов
//    Node.js считывает файл построчно, не загружая гигабайты данных в оперативную память.
// 3. Практическое применение: в бэкенд-разработке на Node.js именно так решается задача
//    сортировки больших лог-файлов или дампов баз данных.

const fs = require('fs');
const readline = require('readline');

// В JS лучше работать с файлами асинхронно, чтобы не блокировать Event Loop
async function externalSort(inputFile, outputFile) {
    const CHUNK_SIZE = 10000; // Ограничение буфера оперативной памяти
    const tempFiles = [];

    // =========================================================
    // ФАЗА 1: Чтение частями, сортировка в памяти и запись прогонов
    // =========================================================
    // Используем Readline для потокового чтения, чтобы не грузить весь файл в память
    const rl = readline.createInterface({
        input: fs.createReadStream(inputFile),
        crlfDelay: Infinity
    });

    let chunk = [];
    for await (const line of rl) {
        chunk.push(line);
        // Как только буфер накопился до предела - сортируем и сбрасываем на диск
        if (chunk.length >= CHUNK_SIZE) {
            // В JS Array.sort сортирует строки лексикографически,
            // если нужны числа - передайте функцию (a, b) => a - b
            chunk.sort();

            const tmpName = run_${tempFiles.length}.tmp;
            // Синхронная запись здесь для простоты, в проде лучше потоковая запись
            fs.writeFileSync(tmpName, chunk.join('\n') + '\n');
            tempFiles.push(tmpName);

            chunk = []; // Очищаем массив (освобождаем ОЗУ) для следующей порции
        }
    }

    // Дописываем и сортируем остаток (самый последний, неполный кусок)
    if (chunk.length > 0) {
        chunk.sort();
        const tmpName = run_${tempFiles.length}.tmp;
        fs.writeFileSync(tmpName, chunk.join('\n') + '\n');
        tempFiles.push(tmpName);
    }

    // =========================================================
    // ФАЗА 2: k-путевое слияние прогонов
    // =========================================================
    // Создаем асинхронные итераторы для построчного, бережного чтения каждого прогона
    const streams = tempFiles.map(file => {
        const lineIterator = readline.createInterface({
            input: fs.createReadStream(file),
            crlfDelay: Infinity
        })[Symbol.asyncIterator]();
        // Структура хранит сам итератор и его текущий элемент (голову прогона)
        return { file, iterator: lineIterator, currentLine: null };
    });

    // Инициализация: читаем первые строки из всех прогонов
    for (const stream of streams) {
        const { value, done } = await stream.iterator.next();
        if (!done) stream.currentLine = value;
    }

    // Поток записи в итоговый отсортированный файл
    const out = fs.createWriteStream(outputFile);

    // В цикле постоянно ищем наименьший элемент среди голов всех прогонов
    while (true) {
        let minIdx = -1;
        for (let i = 0; i < streams.length; i++) {
            if (streams[i].currentLine !== null) {
                if (minIdx === -1 || streams[i].currentLine < streams[minIdx].currentLine) {
                    minIdx = i; // Нашли новый минимум
                }
            }
        }

        // Если minIdx остался -1, значит все прогоны полностью прочитаны
        if (minIdx === -1) break;

        // Пишем найденный минимальный элемент в итоговый результат
        out.write(streams[minIdx].currentLine + '\n');

        // Подгружаем следующую строку ИЗ ТОГО ЖЕ прогона, откуда только что взяли элемент.
        // Таким образом в памяти всегда ровно по одному элементу из каждого файла!
        const { value, done } = await streams[minIdx].iterator.next();
        streams[minIdx].currentLine = done ? null : value;
    }

    out.end();

    // =========================================================
    // Очистка: удаляем временные файлы-прогоны за собой
    // =========================================================
    for (const file of tempFiles) {
        fs.unlinkSync(file);
    }
}
Хотите разобрать тему глубже? В нашем бесплатном курсе есть подробные уроки по всем базовым алгоритмам сортировки и структурам данных.